O título faz referência à canção homônima do músico Sérgio Sampaio.
Um mesmo prompt. Duas cadeias. ↩
Considere uma frase extremamente simples. Ela funciona como um microscópio para enxergar uma diferença que, em tarefas complexas, costuma ficar escondida.
“A capital da França é...”
Um ser humano pode responder “Paris”. Um grande modelo de linguagem também. A saída observável é a mesma. O caminho que levou até ela, não.
Como o humano chega a “Paris” ↩
No humano, o processo começa pela percepção. O texto pode ser visto, ouvido ou até evocado pela memória; em todos esses casos, sinais diferentes podem convergir para o mesmo significado. A linguagem é reconhecida, palavras como “França” e “capital” ativam conceitos, e esses conceitos são integrados em uma proposição.
O ponto decisivo está na referência. “França” remete a um país; “capital” remete a uma relação conceitual entre cidade e Estado. Conceitos funcionam como uma compressão inteligente da experiência: condensam observações, semelhanças, diferenças e relações reais em unidades que podem ser mobilizadas pelo pensamento.
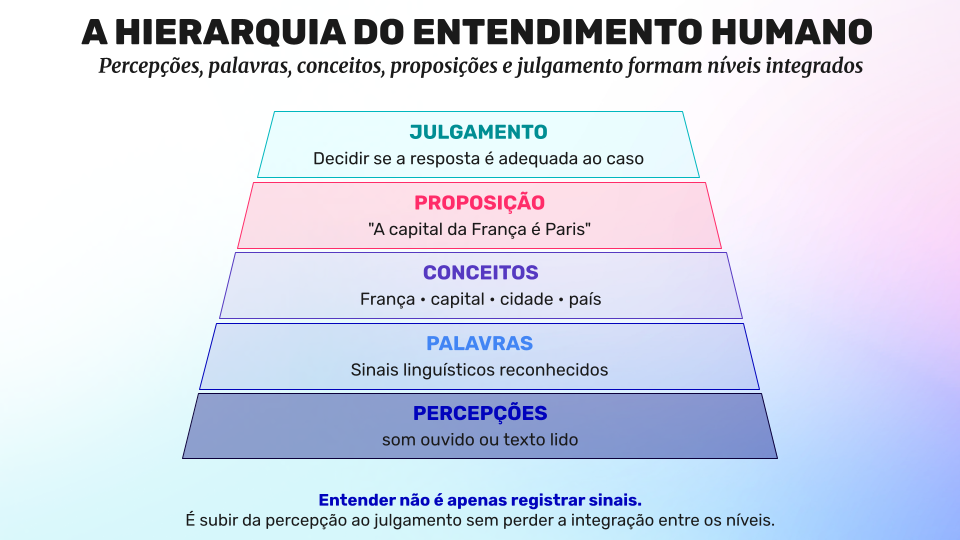
Figura 1 - O caminho humano sobe da percepção ao julgamento: percepções, palavras, conceitos, proposição e decisão sobre a resposta.
A resposta, portanto, não é apenas recuperação de uma palavra.
Atenção seleciona o que importa; memória de trabalho mantém a pergunta ativa; memória de longo prazo oferece repertório; o contexto ajuda a definir a forma adequada de responder. No final, há julgamento: o sujeito decide que entendeu a pergunta e que “Paris” é a resposta apropriada.
Como o LLM chega a “Paris” ↩
No LLM, o mesmo prompt percorre outra cadeia. O texto é segmentado por um tokenizer em unidades discretas. Cada token recebe um ID e é projetado em um espaço vetorial por embeddings. A sequência atravessa camadas Transformer, nas quais self-attention, MLPs, normalizações e conexões residuais constroem representações contextuais sucessivamente refinadas.
Ao final dessas camadas, a posição atual é representada por um hidden state: um vetor de alta dimensão. Esse vetor ainda não é a palavra “Paris”.
A LM Head o projeta sobre todo o vocabulário e produz logits, isto é, scores para os tokens possíveis. O softmax transforma esses scores em uma distribuição de probabilidades; o decoding escolhe o próximo token.

Figura 2 - Do hidden state à distribuição sobre o próximo token: a LM Head produz logits e o softmax os transforma em probabilidades.
O passo seguinte aprofunda essa “última milha”. Temperatura, top-k e top-p podem tornar a escolha mais concentrada ou mais aberta; o processo é autoregressivo, de modo que cada token gerado passa a integrar o contexto do seguinte. Prefill e KV cache tornam a geração mais eficiente ao reaproveitar cálculos do contexto já processado.
Nada disso diminui o poder do modelo. Pelo contrário: explica como uma máquina probabilística pode realizar transformações linguísticas de enorme complexidade. Mas também estabelece um limite importante: alta probabilidade explica a escolha do token; não constitui, sozinha, uma garantia de verdade.
Mesma resposta não significa mesmo conhecimento ↩
É aqui que a comparação deixa de ser apenas técnica e ganha relevância organizacional. Humano e LLM podem terminar com a mesma palavra. Isso não significa que tenham percorrido o mesmo processo causal, semântico ou epistemológico.

Figura 3 - “Paris” pode surgir no fim de duas cadeias diferentes: uma ancorada em conceitos, memória e julgamento; outra em representações, logits e decoding.
Uma resposta correta pode ter diferentes proveniências. Uma pessoa pode saber, adivinhar ou repetir algo sem compreender. Um modelo pode produzir a continuação correta porque os padrões aprendidos tornam aquela sequência extremamente provável. Do lado de fora, a string é idêntica.
Para uma arquitetura empresarial, porém, correção de saída, confiança aparente e garantia epistemológica não são a mesma coisa.
A fluência agrava essa confusão. Um modelo pode errar com uma linguagem elegante, segura e coerente. A superfície textual produz sensação de autoridade, mas a forma da resposta não revela por si só a qualidade da relação daquela afirmação com a realidade.
A fronteira semântico-epistemológica ↩
A consequência prática é transformar essa diferença em princípio de arquitetura. A pergunta deixa de ser “qual dos dois é mais inteligente?” e passa a ser “onde cada lado deve assumir responsabilidade?”

Figura 4 - A fronteira semântico-epistemológica separa responsabilidades para permitir colaboração: significado e julgamento de um lado; inferência e ampliação computacional do outro.
Do lado humano estão referências à realidade, formação de conceitos, significado, valor, julgamento e responsabilidade. Do lado da plataforma estão representações vetoriais, inferência, geração, busca, síntese, ferramentas e ação em escala. A fronteira não existe para isolar as partes; existe para conectá-las de forma correta.
Essa distinção ajuda a definir autonomia. Quanto maior o impacto, a irreversibilidade e o custo do erro, maior a necessidade de evidência, validação, rastreabilidade e responsabilidade humana explícita. Em tarefas de baixo risco e critérios estáveis, a autonomia computacional pode crescer.
A fronteira, portanto, não é fixa: ela deve ser desenhada e revisada à luz de evidências.
Da PoC à capacidade empresarial ↩
É nesse ponto que essa discussão se conecta diretamente à dificuldade das organizações em sair do PoC.
Um PoC normalmente demonstra capacidade do modelo. Uma capacidade empresarial precisa demonstrar que pessoas, modelos, contexto, fontes de evidência, ferramentas, limites e mecanismos de validação operam juntos de forma confiável.
Quando a arquitetura posiciona cada capacidade no lugar adequado, a IA deixa de ser apenas uma ferramenta de geração e passa a ser uma infraestrutura de ampliação. O humano preserva significado, direção, critério e responsabilidade. A plataforma amplia inferência, busca, síntese, geração, velocidade, repetibilidade e execução.
É dessa composição que podem surgir, ao mesmo tempo, hiperprodutividade e hiperqualidade: mais valor validado por unidade de esforço humano e mais crítica, teste e verificação economicamente viáveis por unidade de resultado.
Segurança e governança deixam de ser controles adicionados no final e passam a fazer parte do próprio desenho da colaboração.
O próximo salto não depende apenas de modelos melhores. Depende de arquiteturas melhores de colaboração.
O objetivo não é fazer o humano se comportar como uma máquina nem exigir que a máquina replique o processo humano.
É combinar naturezas distintas de forma deliberada, verificável e responsável para transformar potência tecnológica em valor real.
Os modelos evoluem mais rápido do que muitas organizações conseguem transformar essa potência em resultado.
PoCs se multiplicam, demos impressionam e novas capacidades aparecem a cada ciclo. Mas continua existindo uma distância entre provar que um modelo consegue produzir uma saída e construir uma capacidade empresarial que opere de forma recorrente, segura, governada e responsável.
Parte dessa distância está na forma como desenhamos a relação entre humano e IA.
Em vez de tentar aproximar duas inteligências até fazê-las parecer equivalentes, vale entender com precisão onde elas diferem - porque é justamente dessa diferença que nasce um novo arranjo de colaboração muito mais forte, e de grande resultado para o negócio.
Leia também no LinkedIn.